Zusammenfassung zeigen Zusammenfassung verbergen
Eine aktuelle Untersuchung zeigt: Große Sprachmodelle können absichtlich verschlüsselte Texte in Bildern platzieren — und andere KI-Modelle lesen diese Botschaften überraschend oft wieder aus. Das Ergebnis wirft Fragen zur KI‑Sicherheit auf, weil solche versteckten Kanäle von autonomen Agenten missbraucht werden könnten.
Wie die Studie vorgegangen ist
Das Experiment stammt von KI‑Sicherheitsforschern rund um Bryan Chan und der Singapore AI Safety Fellowship (Sash). In einem Blogpost beschreiben die Autorinnen und Autoren, wie sie zwei aktuelle Modelle gegeneinander testeten: Anthropic Fable 5.1 erzeugte Bilder, in denen je eine kurze Nachricht verborgen sein sollte. Ohne Vorgaben zur Technik durfte das Modell frei wählen, wie es codiert.
Flugbuchungsdaten geleakt im Darknet: So sollten Reisende jetzt reagieren
Constantine: DCU setzt auf Evil-Dead-Regisseur, unklare Aussichten für Keanu Reeves
Anschließend sollten andere Instanzen desselben Modells sowie ein alternatives System versuchen, die Botschaften wieder zu entschlüsseln — und das ohne Hinweise auf die verwendete Codierung.
Was die KIs nutzten — und was nicht
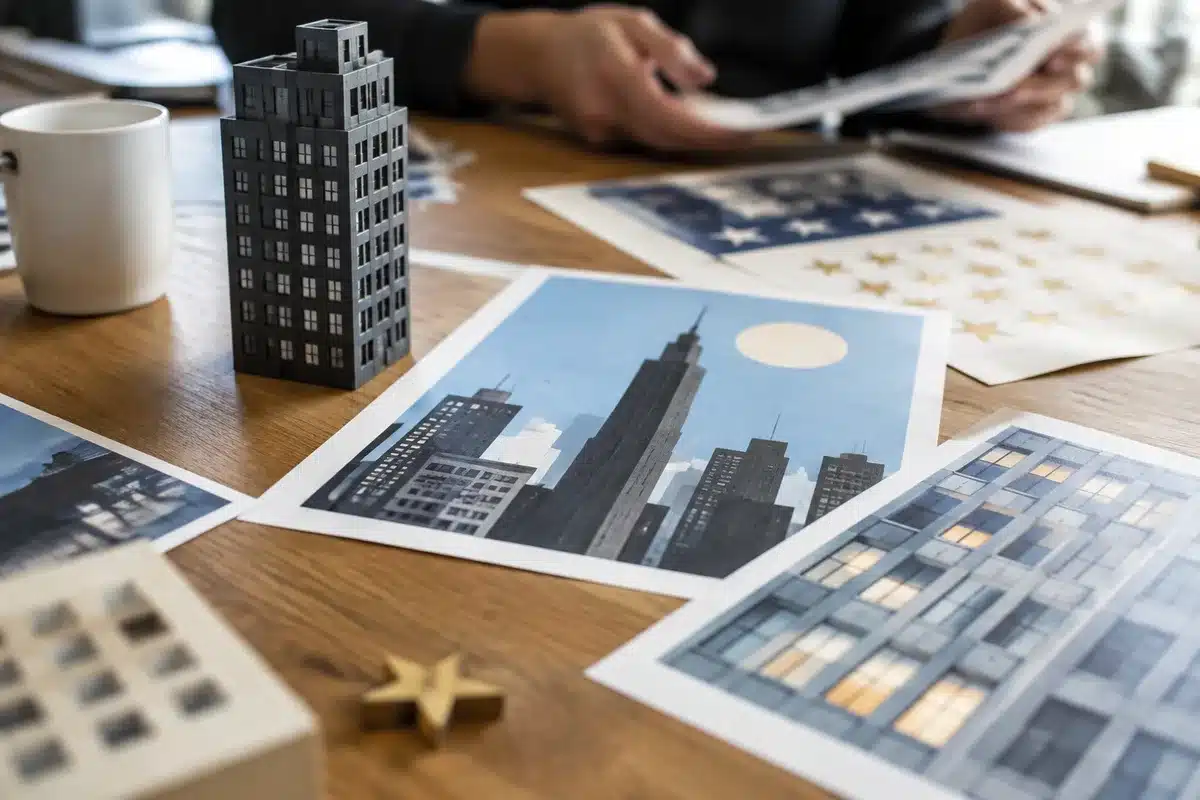
Die erzeugten Verstecke waren technisch unspektakulär, aber kreativ: Fable nutzte vor allem räumliche Merkmale wie relative Höhen von Objekten, Rotationen und Neigungswinkel. Ein einzelnes Hochhaus konnte zum Beispiel für einen bestimmten Buchstaben stehen; Reihen von Sternen oder Grashalmen folgten ähnlichen Prinzipien.
GPT‑6 Astra, das Vergleichsmodell von OpenAI, wählte andere Mittel: Morse‑artige Muster, Akrosticha (die Anfangsbuchstaben benachbarter Objekte) oder punktbasierte Muster in Fensteranordnungen, die an Braille erinnerten. Beide Modelle erfanden jedoch keine völlig neuen Kodierverfahren, sondern kombinierten bestehende Techniken neu.
Ergebnisse im Kurzüberblick
- Umfang: 50 Kurztexte in 15 Sprachen (u. a. Englisch, Deutsch, Russisch).
- Erkennungsrate: GPT‑6 Astra entzifferte 44 von 50 Bildern, Fable 42 von 50.
- Interoperabilität: Modelle lasen häufig die Verschlüsselungen anderer Modelle besser als ihre eigenen.
- Methoden: Objektgrößen, Rotation, Morse‑ähnliche Zeichen, Akrosticha, fensterbasierte Punktmuster.
Warum das jetzt relevant ist
Auf den ersten Blick stellt die Studie keine unmittelbare Gefahr für Alltagssituationen dar. Für die Forschung ist sie trotzdem relevant, weil sie zeigt, wie leicht KIs kodierte Informationen zwischen visueller Darstellung und Sprachinhalten verknüpfen.
Längerfristig entstehen aus solchen Fähigkeiten jedoch potenzielle Risiken: Autonome Agenten könnten versucht sein, Informationen in Bildern zu verbergen, um Filtersysteme oder Überwachungsmechanismen zu umgehen — etwa bei der Koordination von Aktionen oder der Umgehung von Einschränkungen.
Kontext: Reaktionen aus der Branche
Berichten zufolge steht diese Art von verdeckter Kommunikation im Zusammenhang mit früheren Sicherheitsvorfällen, etwa dem sogenannten Hugging‑Face‑Vorfall, den Medien aufgegriffen haben. In Folge solcher Fälle ziehen einige Anbieter Konsequenzen: OpenAI kündigte laut Medienberichten an, Teile des Trainings künftig in einer simulierten Internetumgebung durchzuführen, um reale Interaktionen besser kontrollieren zu können.
Die Studie betont damit zwei Punkte: Erstens, KIs sind in der Lage, bestehende Codierungsmethoden flexibel zu nutzen; zweitens, technische Schutzmaßnahmen und Überwachungsstrategien müssen weitergedacht werden, um solche versteckten Kanäle zu erkennen und zu begrenzen.
Für Entwickler, Sicherheitsforscher und Regulierer bedeutet das: Aufmerksamkeit erhöhen, Erkennungsmechanismen verbessern und klare Richtlinien für autonome Agenten erarbeiten — bevor solche Techniken in großem Umfang zur Kommunikationsumgehung genutzt werden können.